BioSyn 论文讲解分析 PPT 大纲
第1页:标题页
Biomedical Entity Representations with Synonym Marginalization
生物医学实体表示与同义词边缘化
- ACL 2020
第2页:目录
- 研究问题
- 相关工作
- 核心方法
- 双向量表示
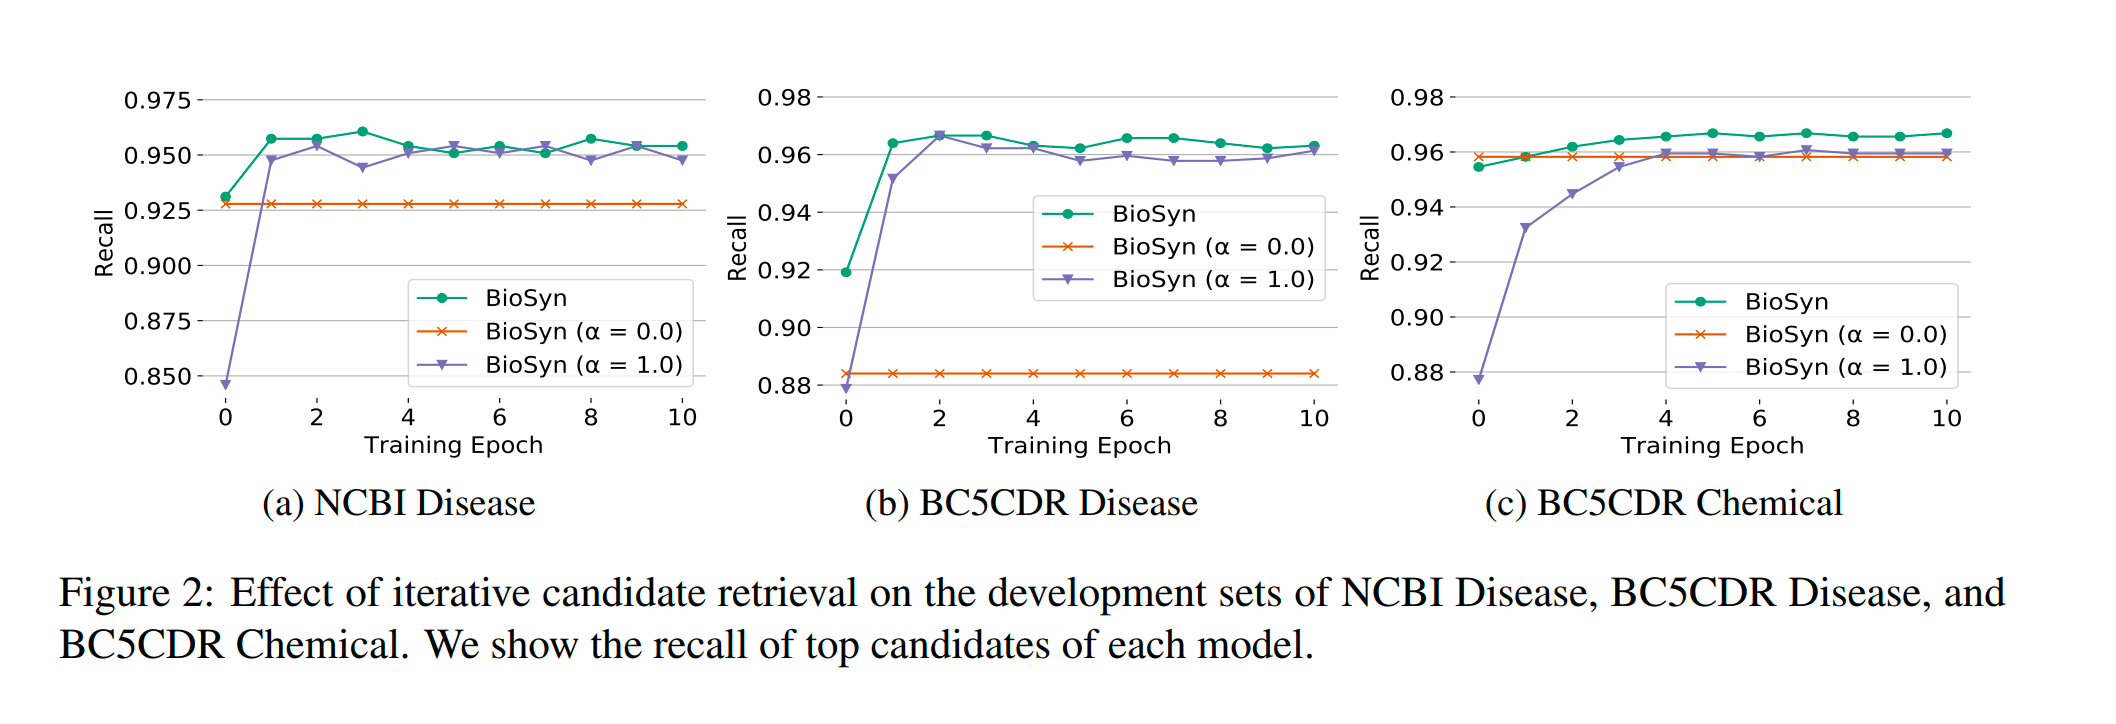
- 迭代候选检索
- 同义词边缘化
- 技术细节
- 训练细节
- 推理过程
- 实验与结果
- 创新点总结
第3页:研究问题
核心挑战
Solve problems of the incompleteness of provided synonyms and numerous variations in their surface forms.
-
同义词不完整
- 医学知识库中的同义词列表往往不完整
- 新术语、缩写、拼写变体层出不穷
-
表面形式多样
- 同一概念可能有多种表达方式
- 例:"aspirin" vs "ASA" vs "acetylsalicylic acid"
-
负样本选择困难
- 传统方法需要显式选择负样本
- 负样本质量影响模型性能
第4页:相关工作
传统方法局限
| 方法 | 局限性 |
|---|---|
| 字符串匹配 | 无法处理变体和缩写 |
| TF-IDF | 缺乏语义理解 |
| 传统神经网络 | 需要大量负样本 |
BioBERT
- 基于BERT的生物医学预训练模型
- 在PubMed摘要和PMC全文上预训练
- 适合生物医学NLP任务
第5页:核心方法概述
具体的模型的图示 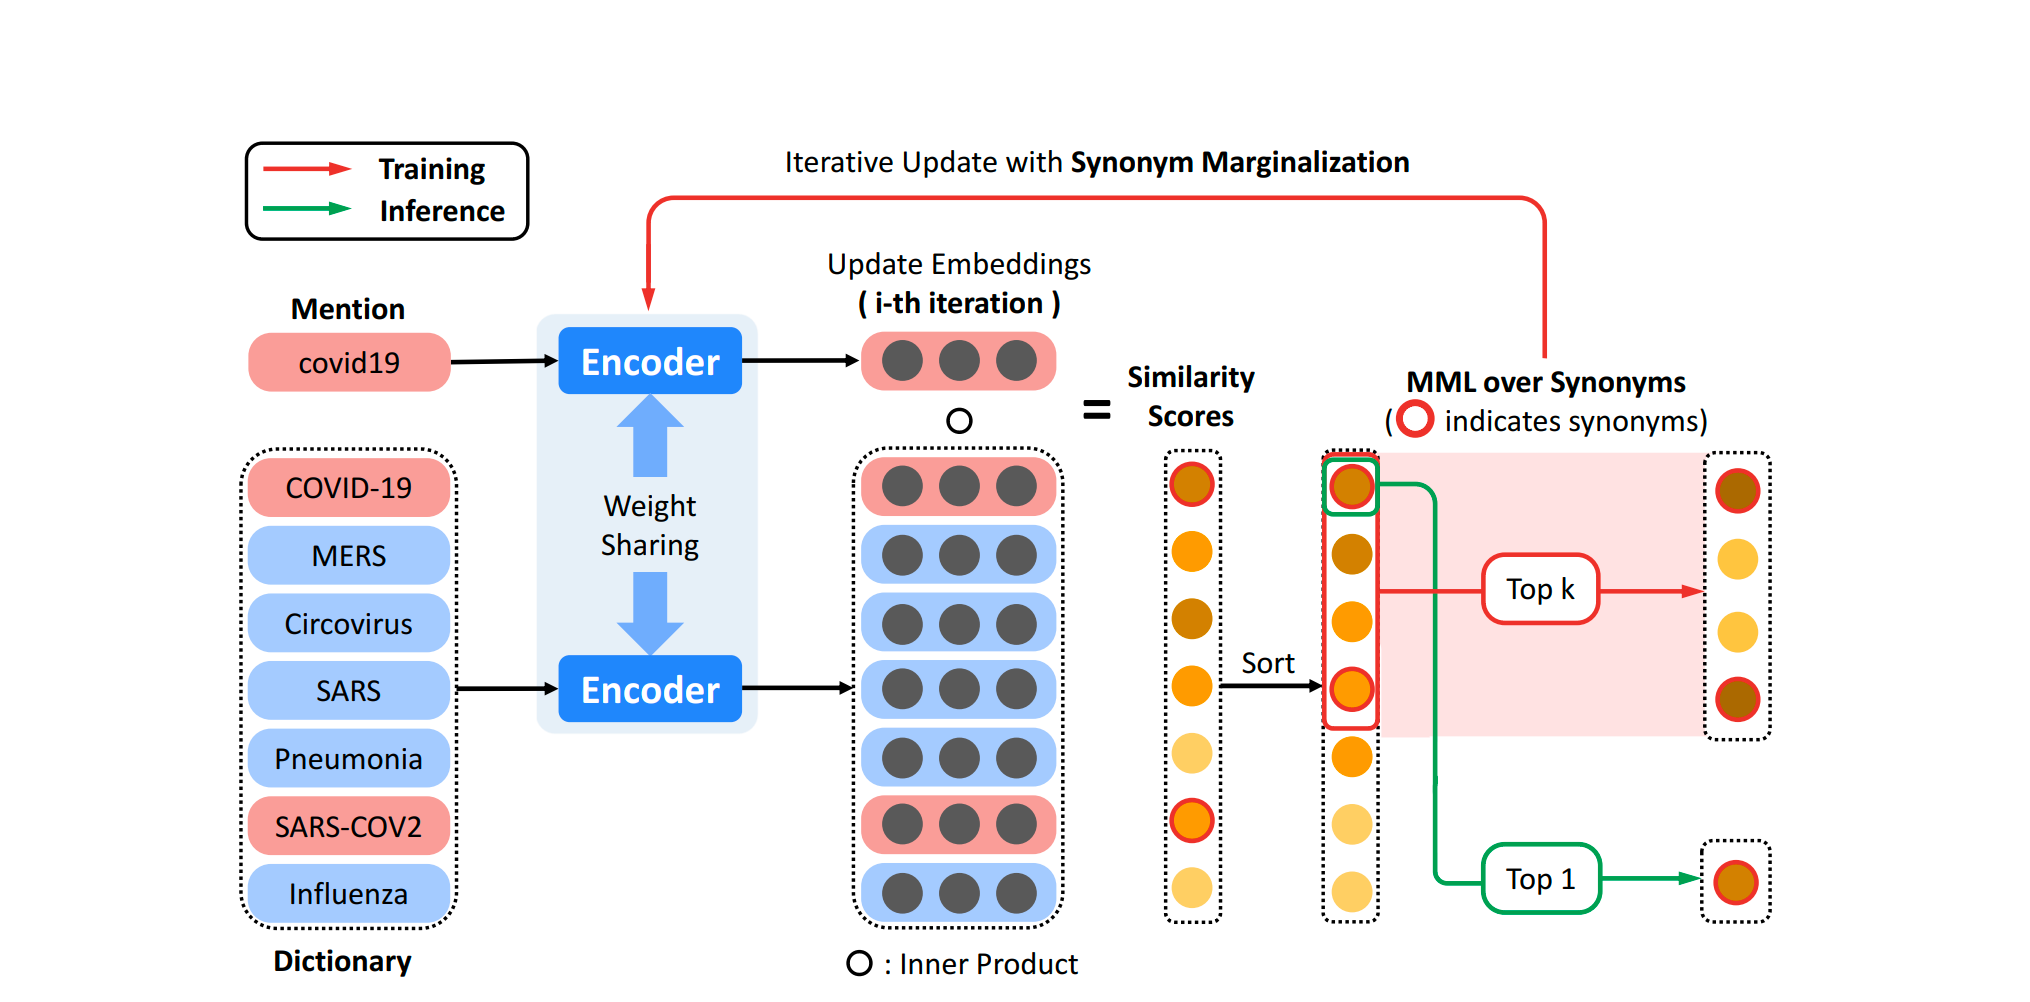 三大核心创新:
- 同义词边缘化(Synonym Marginalization)
- 迭代候选检索(Iterative Candidate Retrieval)
- 双向量表示(Sparse + Dense)
第6页:双向量表示
稀疏向量(Sparse Representation)
- 方法:TF-IDF on character-level n-grams, 一种分析词的结构的统计方法
- 编码内容:形态学信息(Morphological Information)
- 优势:捕捉字符串结构特征, 结果固定,只需要跑一次 输入为一个个字符串(mention 和 synonyms), 输出为这些词对应的Sparse vector
密集向量(Dense Representation)
- 方法:BioBERT, 取出[CLS] Token
- 编码内容:语义信息(Semantic Information)
- 优势:捕捉上下文语义 输入为一个个字符串(mention 和 synonyms), 输出为这些词对应的Dense vector
双向量融合公式:
第7页:迭代候选检索
选出候选集(选出一部分与查询词的 Sparse vector 相近的词, 一部分 Dense vector 相近的词 )
训练流程
初始化 → 候选检索 → 计算损失 → 更新参数 → 重复
           ↑                         ↓
           └─────────────────────────┘
第8页:同义词边缘化
核心思想
不需要显式负样本,而是最大化正确同义词在候选集中的边缘概率
公式推导
其中:
- :正确同义词
- :top-k候选集合
- :输入提及
- :模型参数
第9页:训练细节
候选检索参数
- α:从密集检索获取的候选比例 (0 ≤ α ≤ 1)
- k:候选数量
- 混合检索: 比例来自密集向量, 来自稀疏向量
损失函数
S为双向量融合公式 双向量融合公式:
第10页:推理过程
Maximum Inner Product Search (MIPS)
找出融合双向量最相近的词
推理流程
输入提及 → BioBERT编码 → MIPS检索 → 返回最近同义词 → 映射CUI
公式:
第11页:实验结果
直接分两页将下面两张图片插入即可 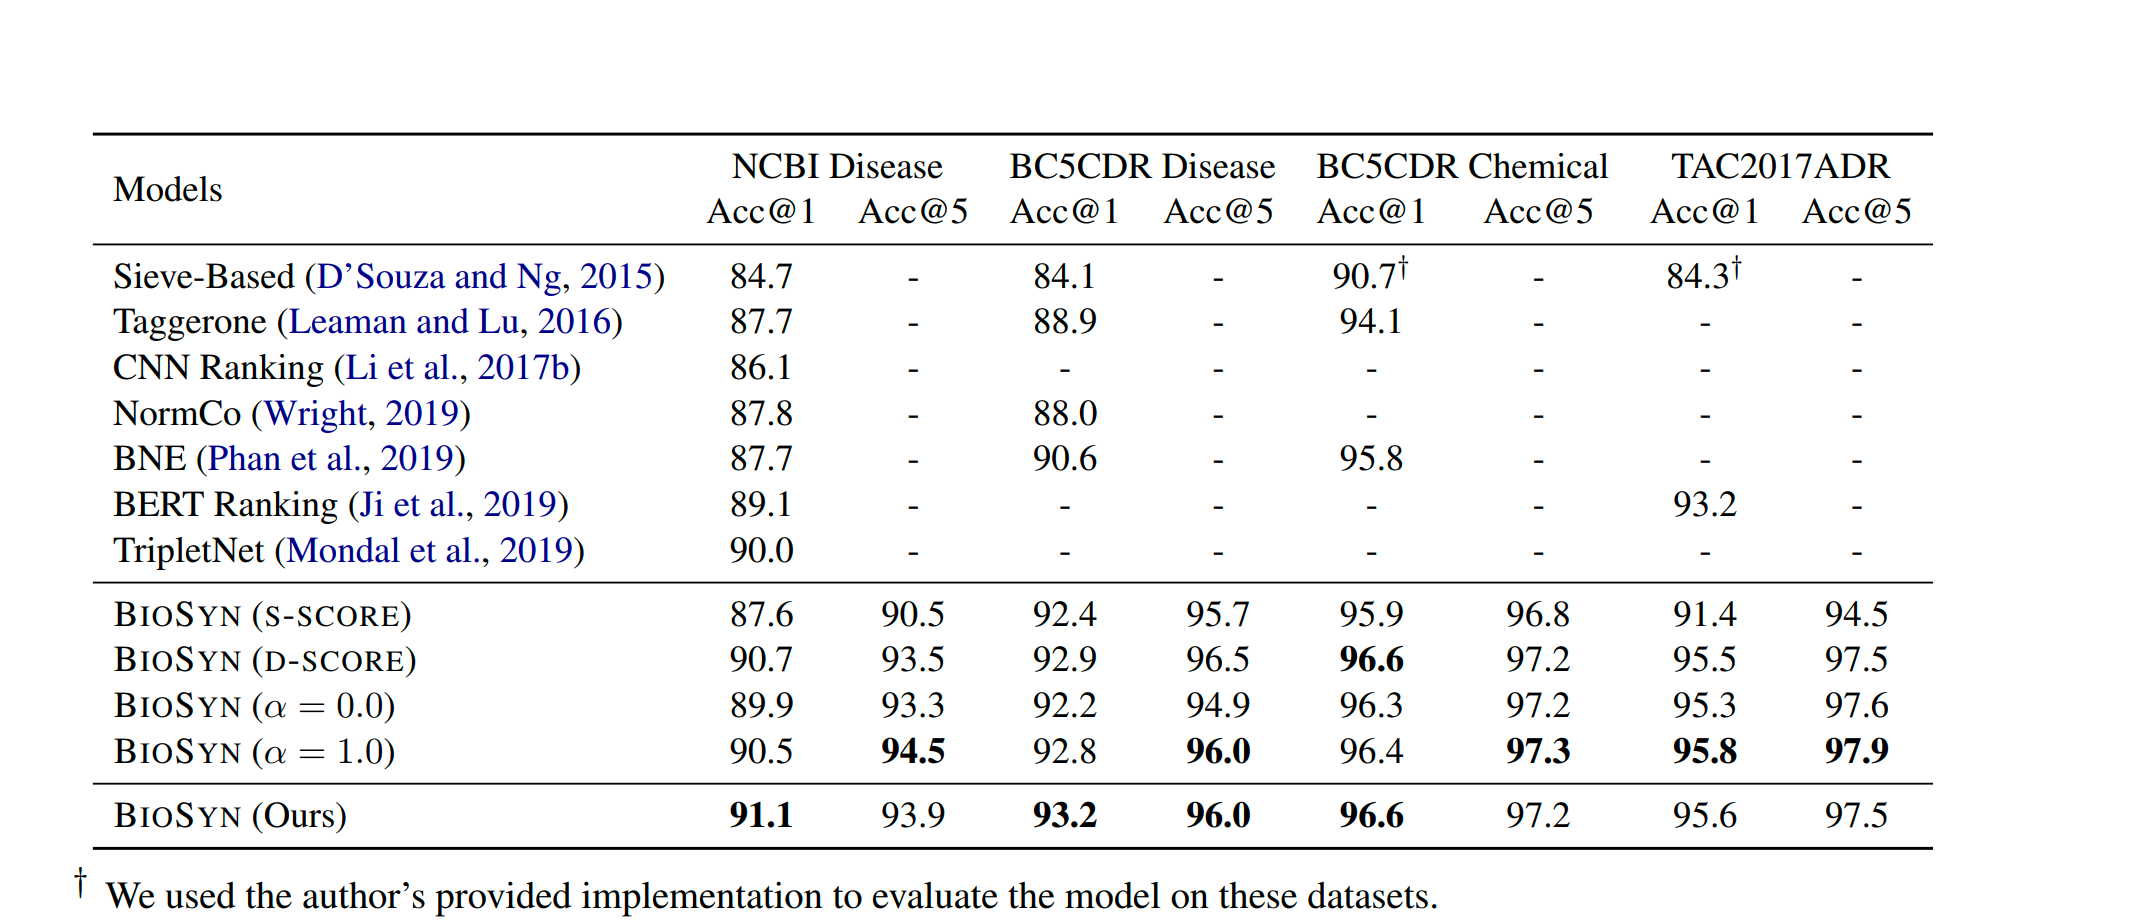
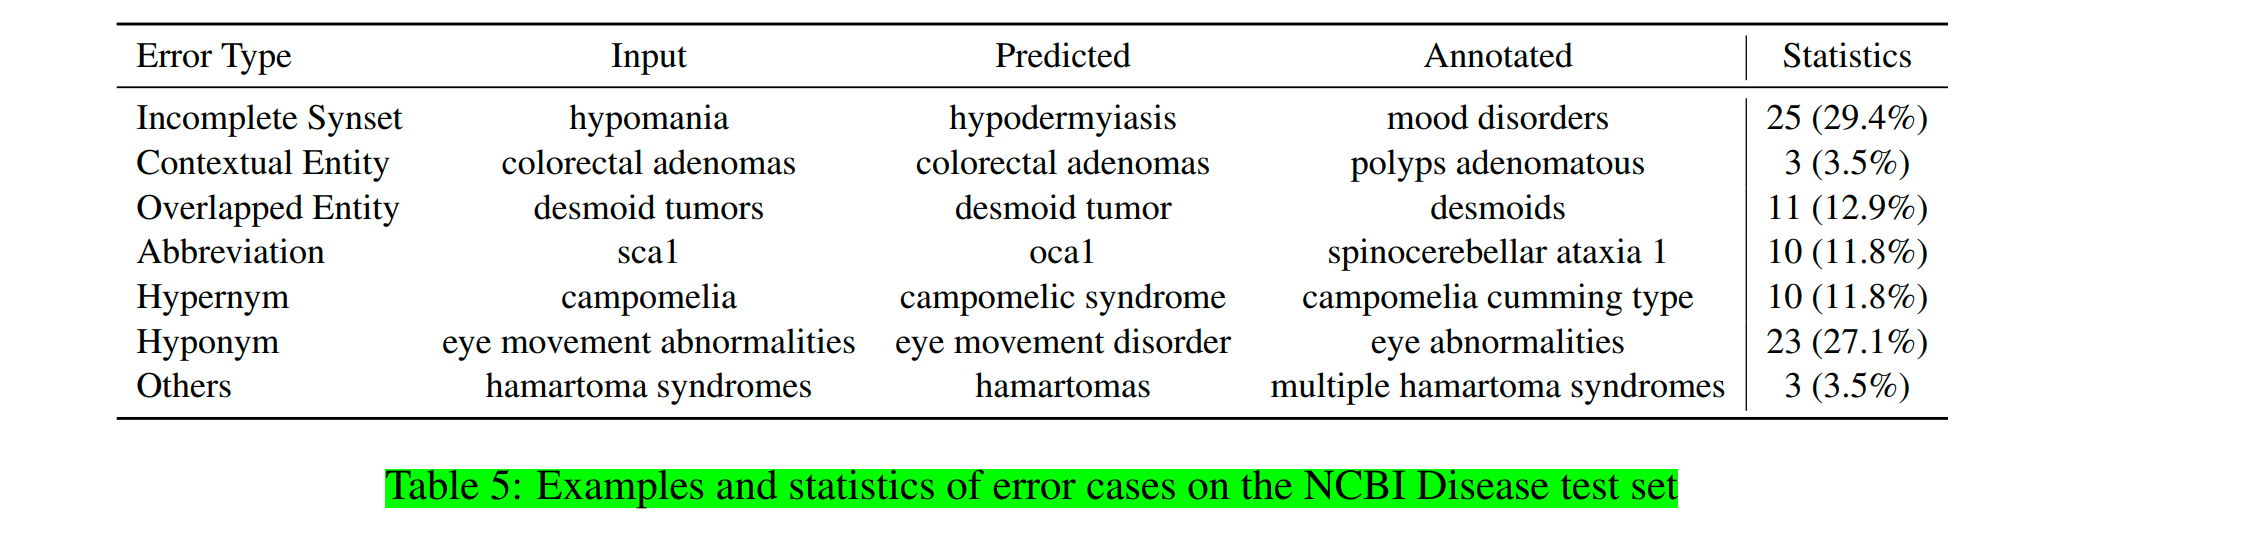
第12页: 错误分析